gallery-dl Tumblr: Blogs und Beiträge herunterladen
gallery-dl Tumblr wird übersichtlicher, wenn Sie URL-Bereich, Zugriff und wiederholte Läufe getrennt betrachten. Dieser Leitfaden zeigt, wie Sie einen öffentlichen Blog testen, einen Tag oder Beitrag gezielt laden, Cookies nur bei Bedarf einsetzen und ein nachvollziehbares lokales Archiv führen.
Blog-URLsTags und SucheCookiesArchive ohne Duplikate
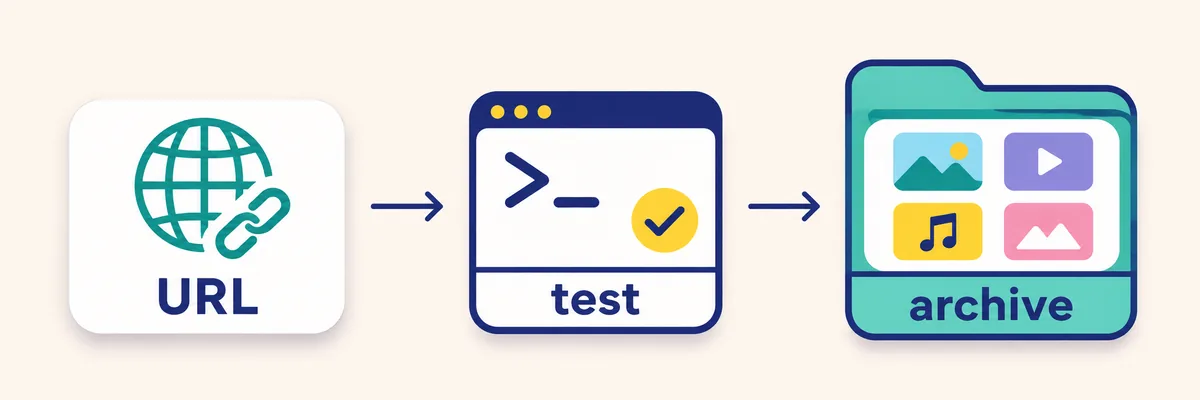
Ein Tumblr-Arbeitsablauf beginnt mit einem kleinen URL-Test und endet mit einem geprüften lokalen Archiv.Kurzantwort
Verwenden Sie eine öffentliche Tumblr-Blog-, Tag-, Beitrags- oder Such-URL. Starten Sie mit gallery-dl --simulate, damit keine Dateien geschrieben werden, und wiederholen Sie danach dieselbe URL mit kleinem Umfang und bekanntem Zielordner. Ergänzen Sie Browser-Cookies nur, wenn Tumblr eine authentifizierte Sitzung verlangt, und führen Sie ein Archiv, wenn der Lauf wiederholt werden soll.
Umfang
Was gallery-dl Tumblr verarbeitet
Der gallery-dl-Tumblr-Extractor ist für Blog-URLs und nicht für einen einzelnen allgemeinen Bild-Endpunkt ausgelegt. Er erkennt Tumblr-Blogs, eigene Subdomains, Beitragslinks und sammlungsähnliche Pfade. Außerdem behandelt er Foto-, Video-, Audio-, Zitat-, Link-, Antwort-, Chat- und Suchbeiträge. Ein Blog kann deshalb Medien und Text mischen, während Sie vielleicht nur einen bestimmten Typ speichern möchten.
Betrachten Sie gallery-dl Tumblr als kontrollierten Archivprozess. Die URL bestimmt den Bereich, der Extractor wandelt ihn in Nachrichten und Medien um, und die Konfiguration legt Ordner, Dateinamen und bereits bekannte Elemente fest. Der Befehl erteilt keinen Zugriff auf private Beiträge, umgeht keine Anmeldung und entscheidet nicht über Ihre Berechtigung, fremde Werke zu speichern.
Diese Seite ist enger als die Liste unterstützter Seiten und konkreter als der allgemeine Nutzungsleitfaden. Installation, Cookie-Export, Dateinamen-Schlüsselwörter und Archivpflege bleiben über die verknüpften Seiten erreichbar; hier stehen die Tumblr-Entscheidungen im Mittelpunkt.
Das passende Denkmodell
Behandeln Sie eine Tumblr-URL als feste Suchgrenze. Eine Blog-URL kann breit sein, ein Tag thematisch, ein Beitrag eignet sich für eine Einzelprüfung und eine Suche verändert sich. Definieren Sie diese Grenze, bevor Sie Pagination, Filter oder einen langen Archivlauf hinzufügen.
Der URL-Bereich bestimmt, was der Extractor findet.
Die Simulation zeigt, was gefunden würde.
Die Konfiguration steuert Pfade, Namen, Pausen und Archive.
Berechtigungen und Tumblr-Regeln bleiben maßgeblich.
URL-Auswahl
Den richtigen Tumblr-URL-Typ wählen
Beginnen Sie mit der kleinsten URL, die Ihre Frage beantwortet. Eine Beitrags-URL prüft die Verarbeitung eines einzelnen Elements. Eine Blog-URL eignet sich für das Archiv eines Autors. Eine Tag- oder Such-URL ist breiter und weniger stabil, weil neue Ergebnisse auftauchen. Entfernen Sie Tracking-Parameter aus mobilen Freigaben nur, wenn die bereinigte URL denselben Bereich zeigt.
Tumblr-Blogs können in mehreren Formen erscheinen. `tumblr.com/blog/name`, `name.tumblr.com` und ein Permalink können denselben Blog meinen, sind aber nicht gleich praktisch für einen Test. Bevorzugen Sie eine kurze, kanonische Form und notieren Sie die ursprüngliche URL.
Nicht jedes Bild in einem Theme ist ein Beitragsmedium. Avatare, Empfehlungen, externe Einbettungen und dekorative Elemente können dazukommen. Prüfen Sie in der Simulation IDs, Medien-URLs und Beitragstypen, bevor Sie einen Filter schreiben.
URL-Bereich
Guter erster Einsatz
Wichtigste Vorsicht
Einzelbeitrag
Parser- und Rechteprüfung
Kann ohne herunterladbares Medium sein
Blog
Archiv eines Autors
Kann sehr groß werden
Tag
Kleines Themensample
Ergebnisse ändern sich
Suche
Kandidaten finden
Schwer reproduzierbar
Eigene Subdomain
Direkter Bloglauf
Zugehörigkeit zu Tumblr prüfen
Mit einer URL beginnen
Eine simulierte Einzelbeitrags-URL liefert bessere Gewissheit als ein großer Befehl, der Theme-Elemente, Reblogs und fremde Suchergebnisse vermischt.
Erster Lauf
Installieren und einen sicheren ersten Test ausführen
Installieren Sie gallery-dl mit der Methode, die zu Ihrer Python- oder Paketumgebung passt. Der Installationsleitfaden erklärt die Optionen; sobald `gallery-dl --version` antwortet, halten Sie den ersten Tumblr-Lauf klein. Eine Simulation zeigt Extractor-Nachrichten ohne Medien zu speichern und macht falsche URLs, Login-Seiten oder einen zu großen Umfang sichtbar.
Nutzen Sie eine Befehlsform wie unten und ersetzen Sie die URL durch ein öffentliches Ziel, das Sie prüfen dürfen. Die Ausgabe ist eine Entscheidungsgrundlage und keine Zusage, dass jeder Beitrag eine Datei enthält.
Wenn die Simulation plausibel aussieht, wählen Sie einen leeren Testordner und führen Sie dieselbe URL ohne `--simulate` aus. Trennen Sie den Ordner von einem bestehenden Archiv, damit Sie Dateien und Nachrichten vergleichen und den Test sicher entfernen können.
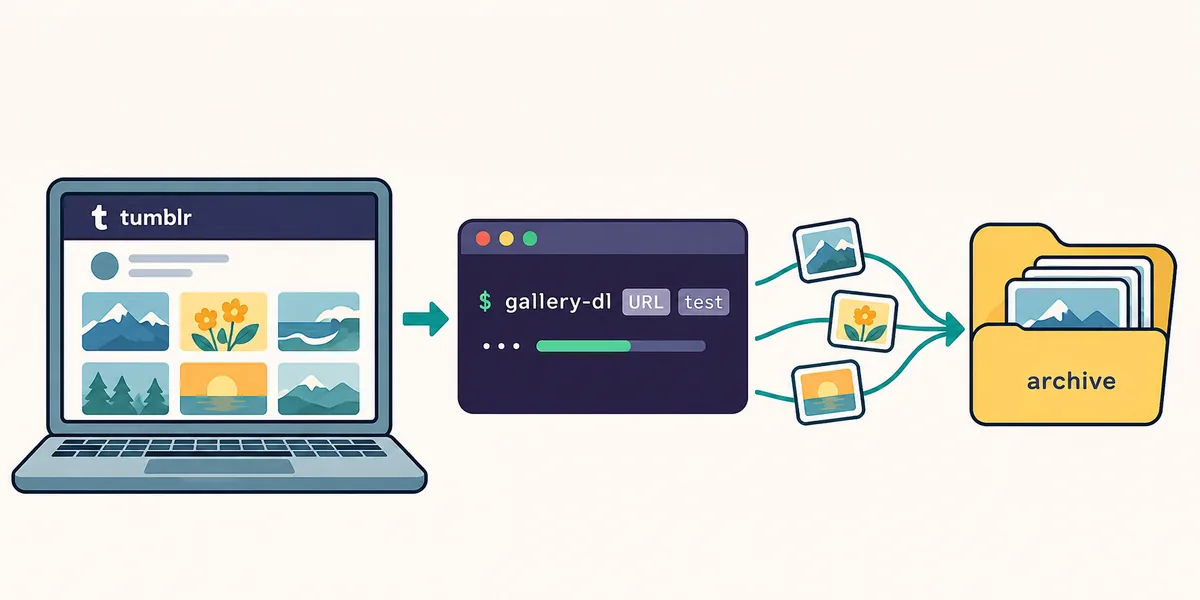
Ein wiederholbarer Tumblr-Lauf wählt eine URL, simuliert das Ergebnis und archiviert zunächst ein kleines Sample.
Die Simulation lesen
Achten Sie auf Extractor, Blog- oder Beitrags-ID, Medien-URLs und Authentifizierungswarnungen. Ein leeres Ergebnis ist kein Grund, sofort Cookies hinzuzufügen. Prüfen Sie zuerst URL-Form, öffentliche Sichtbarkeit und die Fähigkeit Ihrer installierten Version, die aktuelle Antwort zu verarbeiten.
Bei einer neuen URL `--verbose` verwenden, später im Routinebetrieb entfernen.
Vor einem vollständigen Bloglauf mit `--range` klein anfangen.
Blogs, Tags, Beiträge und Suchergebnisse herunterladen
Ein Bloglauf ist häufig, aber nicht für jede Aufgabe der beste Start. Für ein einzelnes Bild verwenden Sie die Beitrags-URL. Für ein Thema verwenden Sie einen Tag mit kleinem Bereich. Zur Erkundung nutzen Sie die Suche und wandeln interessante Treffer anschließend in wiederholbare Beitrags- oder Blogläufe um.
Der Extractor findet mehr als Fotos. Video- und Audiobeiträge können sich anders verhalten; Text-, Zitat- und Antwortbeiträge liefern eventuell keine Datei; Reblogs können Metadaten enthalten, die nicht in den Dateinamen gehören. Prüfen Sie die Beitragstypen in der Simulation, bevor Sie einen Filter bauen.
Bei großen Blogs arbeiten Sie mit Kontrollpunkten. Führen Sie zunächst einen Bereich aus, prüfen Sie Ordner und Archiv und erweitern Sie erst danach. Nach einem Netzwerkfehler ermöglichen stabile Namen und ein Archiv die Fortsetzung, ohne alte Elemente erneut als neu zu behandeln.
Praktische Reihenfolge
Prüfen Sie zuerst einen Beitrag, dann Blog- oder Tag-Bereich. Entscheiden Sie anschließend über Cookies, fügen Sie Ziel und Archiv hinzu und wiederholen Sie erst, wenn das Sample verständlich ist. So trennen Sie Parser- und Zugriffsprobleme.
Beitrags-URL: Einzelprüfung.
Blog-URL: Autoren- oder Sammlungsarchiv.
Tag-URL: begrenztes Themensample.
Such-URL: Entdeckung, kein unveränderlicher Archivschlüssel.
Was ein gutes Ergebnis ist
Ein gutes Ergebnis ist erklärbar: bekannte URL, plausible Dateizahl, enthaltene Typen und klarer Zielordner. Viele Dateien ohne Wiederholbarkeit oder Prüfung ergeben keinen sicheren Ablauf.
Wiederholbarkeit
Konfiguration, Dateinamen und Archive steuern
Überführen Sie stabile Entscheidungen in die gallery-dl-Konfiguration, sobald der Testbefehl klar ist. Dort können Tumblr-Verzeichnis, Namensfelder, Download-Archiv und eine moderate Pause stehen. Eine geprüfte Konfiguration hält manuelle und geplante Läufe konsistent.
Ein Tumblr-Dateiname sollte Blog, Beitrag oder ID und eine laufende Nummer für mehrere Medien erkennen lassen. Verwenden Sie den Vorlagenleitfaden, um Schlüsselwörter zu finden, statt Felder zu raten. Fehlt ein Feld bei einem Beitragstyp, wählen Sie einen lesbaren Ersatz.
Ein Archiv speichert verarbeitete IDs und ersetzt keine Mediensicherung. Legen Sie es neben die Konfiguration, sichern Sie es und veröffentlichen Sie es nicht, wenn URL-Informationen enthalten sind. Verwenden Sie es nach einer Änderung an Pfad oder Namen nur weiter, wenn dieselben logischen Elemente übersprungen werden sollen.
Ein anderer Ordner ändert nicht die Identität des Archivs. Entscheiden Sie vor einem Umzug, ob derselbe Beitrag weiterhin übersprungen werden soll.
Zugriff
Cookies nur verwenden, wenn Tumblr sie verlangt
Öffentliche Tumblr-Seiten sind der erste Test. Sieht der Browser eine Seite, gallery-dl meldet aber einen Zugriffsfehler, können Sitzungscookie, Einwilligungsstatus oder eine geänderte Antwort die Ursache sein. Der Cookie-Helfer erklärt den lokalen Export; übergeben Sie die Datei mit der vorgesehenen gallery-dl-Option, statt Werte in Befehle oder öffentliche Issues zu kopieren.
Cookies machen private Seiten nicht öffentlich und garantieren kein Archivierungsrecht. Sie laufen ab, spiegeln die Kontoberechtigung und können bei Weitergabe Zugang offenlegen. Schützen Sie die Datei, halten Sie sie außerhalb öffentlicher Ordner und löschen Sie sie nach dem Test.
Vergleichen Sie einen fehlgeschlagenen Cookie-Lauf mit einer öffentlichen Simulation. Scheitert auch diese, liegt das Problem eher bei URL, Version, Netzwerk oder Tempo als bei der Anmeldung.
Vorsichtige Zugriffsliste
Öffentliche URL bestätigen, nur nötige Cookies exportieren, einen Beitrag simulieren, Datei nicht committen und Sitzung nach Gebrauch löschen.
Cookie-Header nie in Tutorial, Log oder Issue einfügen.
Authentifizierte Inhalte nicht ohne Erlaubnis veröffentlichen.
Den kleinsten nötigen authentifizierten Bereich verwenden.
Kontrolle
Filter, Pausen und verantwortungsvolle Grenzen
Ein Tumblr-Archiv bleibt verständlich, wenn der Befehl das Ziel beschreibt. Verwenden Sie einen Bereich für das erste Sample, einen Datums- oder Beitragsfilter, wenn die Metadaten es erlauben, und eine Typbedingung bei gemischtem Inhalt. Prüfen Sie jede Bedingung per Simulation, denn ein Filter ohne Treffer wirkt wie ein defekter Extractor.
Eine kurze Pause, ein moderater Bereich und ein Abbruchkriterium sind bessere Ausgangswerte als mehrere vollständige Blogprozesse parallel. Meldet Tumblr ein Limit oder einen temporären Fehler, stoppen Sie, bewahren Sie Logs und versuchen Sie es später kleiner. Umgehen Sie Sperren nicht mit Kontowechsel oder aggressiven Anfragen.
Die technische Möglichkeit, eine Datei zu speichern, ist keine Erlaubnis zur Weiterveröffentlichung. Prüfen Sie Bedingungen des Autors, Tumblr-Regeln und Lizenz oder Urheberrecht. Private oder sensible Inhalte gehören nicht in öffentliche Archive; bewahren Sie die Ursprungs-URL für die Provenienz.
Kontrolle
Nutzen
Prüfung
Kleiner Bereich
Begrenzt ersten Schreibvorgang
Erwartete Reihenfolge stimmt
Beitragstyp
Entfernt Unpassendes
Simulation zeigt Treffer
Pause
Reduziert Spitzen
Lauf bleibt praktikabel
Archiv
Überspringt bekannte IDs
Stabil und gesichert
Separater Ordner
Schützt Bestand
Test kann gelöscht werden
Wiederherstellung
Häufige Tumblr-Fehler beheben
Ordnen Sie den Fehler ein, bevor Sie den Befehl ändern. Ein 404 oder leeres Ergebnis kann falsche URL, verschobenen Blog oder nicht unterstützten Pfad bedeuten. Ein 403 oder Login-Hinweis deutet auf Zugriff, Einwilligung, Cookies oder eine Richtlinienantwort. Timeout oder 429 weisen auf Tempo, Netzwerk oder ein temporäres Limit hin.
Bei einem URL-Problem öffnen Sie die Seite im Browser, kopieren eine kanonische Adresse und testen einen Beitrag mit `--simulate --verbose`. Bei Zugriff vergleichen Sie öffentlichen Beitrag und authentifizierte Sitzung und nutzen den Cookie-Helfer nur, wenn der Vergleich es begründet. Bei einem Limit stoppen, warten, Bereich verkleinern und parallele Läufe vermeiden. Bei unerwarteter Dateizahl prüfen Sie Typen, Reblogs, Theme-Elemente und Filter, bevor Sie das Archiv löschen.
Bewahren Sie den Originalfehler auf. Nennen Sie gallery-dl-Version, Betriebssystem, bereinigten Befehl, URL-Form ohne private Token und ob eine öffentliche Simulation funktioniert. Cookie-Dateien und private Medien gehören nicht in ein öffentliches Ticket.
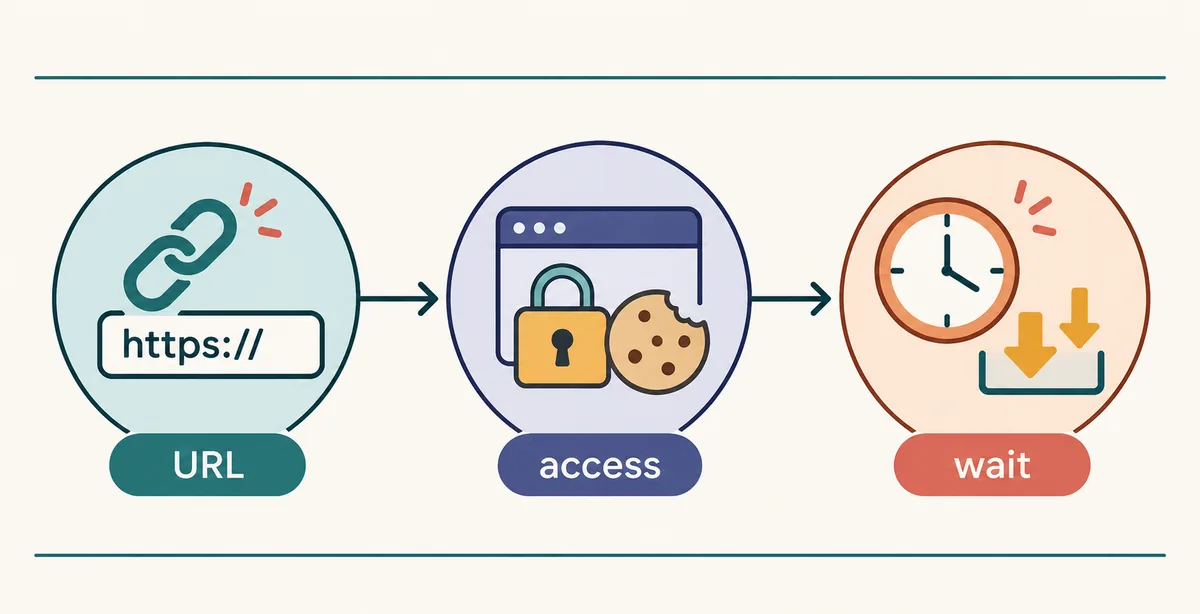
URL-, Zugriffs- und Rate-Limit-Fehler getrennt prüfen, bevor Konfiguration oder Zugangsdaten geändert werden.
Schnelle Diagnosefolge
URL-Form prüfen, einen Beitrag testen, öffentlichen und authentifizierten Zugriff vergleichen und erst danach Filter oder Ausgabe ändern. So wird aus einem Formatfehler kein unübersichtliches Konfigurationsexperiment.
Diese Antworten betreffen Entscheidungen für einen wiederholbaren Tumblr-Lauf. Die verknüpften allgemeinen Seiten liefern zusätzliche Beispiele für nicht plattformspezifische Probleme.
Häufige Fragen
Fragen zu gallery-dl Tumblr
Kann gallery-dl einen ganzen Tumblr-Blog herunterladen?
Eine unterstützte öffentliche Blog-URL kann verarbeitet werden. Beginnen Sie trotzdem mit Simulation und kleinem Bereich, weil Typen, Reblogs und Historie umfangreich sein können. Verwenden Sie vor dem Erweitern stabiles Ziel und Archiv.
Soll ich eine Tumblr-Blog- oder Tag-URL verwenden?
Blog für Autor oder Sammlung, Tag für ein kleines Thema-Sample und Beitrag für eine Einzelprüfung. Such-URLs eignen sich zur Entdeckung, da Ergebnisse wechseln.
Warum liefert gallery-dl Tumblr ein leeres Ergebnis?
Prüfen Sie URL-Form, Sichtbarkeit, Version und Simulation. Möglich sind falscher Pfad, nicht unterstützter Zustand, leerer Filter oder erforderlicher Zugriff.
Brauche ich Cookies für Tumblr?
Nicht für jede öffentliche Seite. Verwenden Sie Cookies nur, wenn Vergleich und Fehlermeldung eine Sitzung zeigen. Datei privat halten; sie erteilt keine Rechte für private Inhalte.
Wie verhindere ich doppelte Tumblr-Beiträge?
Ein stabiles Archiv konfigurieren und mit dem Job aufbewahren. Änderungen an Ordnern oder Namen separat testen, damit klar ist, welche IDs übersprungen werden.
Was tun nach 429 oder Timeout?
Stoppen, Log behalten, warten, Bereich reduzieren und mit moderater Pause neu starten. Keine parallelen Wiederholungen und kein Kontowechsel zum Umgehen eines Limits.