gallery-dl Tumblr: guía para descargar blogs y publicaciones
El soporte de gallery-dl Tumblr se entiende mejor si separas el alcance de la URL, el acceso y el control de las ejecuciones repetidas. Aquí aprenderás a probar un blog público, descargar una etiqueta o publicación concreta, añadir cookies solo cuando sea necesario y mantener un archivo local predecible.
URL de blogEtiquetas y búsquedaCookiesArchivos sin duplicados
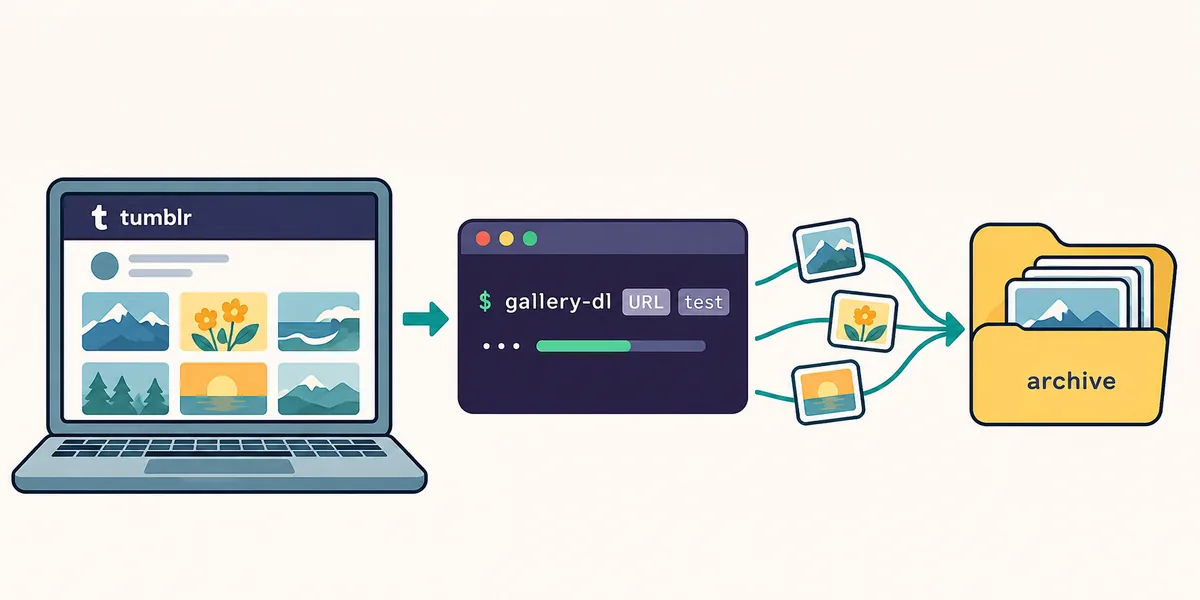
Un flujo específico para Tumblr empieza con una prueba pequeña y termina en un archivo local revisado.Respuesta rápida
Usa como entrada una URL pública de blog, etiqueta, publicación o búsqueda de Tumblr. Empieza con gallery-dl --simulate para ver el resultado sin escribir archivos; después repite la misma URL con un alcance pequeño y un destino conocido. Añade cookies del navegador solo si Tumblr exige una sesión autenticada y conserva un archivo de historial cuando pienses repetir el trabajo.
Alcance
Qué gestiona gallery-dl Tumblr
El extractor de gallery-dl Tumblr está pensado para URL con estructura de blog, no para un único punto genérico de imágenes. Reconoce blogs de Tumblr, subdominios personalizados, enlaces de publicaciones y rutas de colecciones. También contempla tipos de publicación como foto, vídeo, audio, cita, enlace, respuesta, chat y resultados de búsqueda. Esto es importante porque un mismo blog puede mezclar medios y texto, mientras que tu objetivo puede ser guardar solo una clase de elemento.
Piensa en gallery-dl Tumblr como un flujo de archivo controlado. La URL define el alcance, el extractor convierte ese alcance en mensajes y medios, y tu configuración decide dónde se guardan los archivos, cómo se nombran y si un elemento ya es conocido. El comando no concede acceso a publicaciones privadas, no evita un inicio de sesión ni decide si tienes permiso para conservar la obra de otra persona.
Esta página es más concreta que la lista de sitios compatibles y más específica que la guía general de uso. Aquí están las decisiones propias de Tumblr; las páginas enlazadas cubren instalación, exportación de cookies, palabras clave de nombres y mantenimiento del archivo.
Un modelo mental útil
Trata una URL de Tumblr como un límite de consulta. La URL de un blog puede ser amplia, una etiqueta puede ser temática, una publicación sirve para una comprobación de un solo elemento y una búsqueda cambia con el tiempo. Define ese límite antes de añadir paginación, filtros o un archivo que se ejecutará durante mucho tiempo.
El alcance de la URL decide qué descubre el extractor.
La simulación confirma qué se descubriría.
La configuración controla rutas, nombres, pausas y archivos.
Los permisos y las condiciones de Tumblr siguen determinando lo que puedes conservar.
Selección de URL
Elige el tipo de URL de Tumblr correcto
Empieza con la URL más pequeña que responda a tu pregunta. Una publicación sirve para verificar que gallery-dl puede analizar un elemento concreto. Una URL de blog tiene sentido si vas a seguir los medios de un autor. Una etiqueta o búsqueda es más amplia y menos estable porque pueden aparecer resultados nuevos entre ejecuciones. Si copias una dirección desde una aplicación móvil, elimina parámetros de seguimiento solo después de confirmar que la URL limpia apunta al mismo alcance.
Los blogs de Tumblr pueden aparecer con varias formas. Un enlace `tumblr.com/blog/nombre`, un subdominio `nombre.tumblr.com` y un enlace permanente pueden señalar el mismo blog, pero no son igual de cómodos para una prueba. Prefiere la forma más corta y canónica y anota la URL original para explicar una diferencia posterior.
No supongas que cada imagen visible en un tema es una publicación descargable. Los temas pueden incluir avatares, recomendaciones, inserciones externas o recursos decorativos. Las líneas de resultado de la simulación son el límite útil: revisa identificadores, medios y tipos de publicación antes de crear un filtro.
Alcance
Primer uso recomendado
Precaución
Una publicación
Comprobar análisis y permisos
Puede no contener un medio descargable
Blog
Archivo de un autor o colección
Puede convertirse en una tarea grande
Etiqueta
Muestra de un tema
Los resultados cambian con el índice
Búsqueda
Descubrimiento inicial
Es difícil reproducirla exactamente
Subdominio
Flujo directo de un blog
Confirma que pertenece a Tumblr
Empieza con una URL
Una simulación de una sola publicación ofrece una evidencia más clara que un comando grande que mezcle recursos del tema, reblogs y resultados no relacionados.
Primera ejecución
Instala y ejecuta una primera prueba segura
Instala gallery-dl con el método que encaje con tu entorno de Python o paquetes. La guía de instalación del sitio explica las opciones; cuando `gallery-dl --version` responda, haz que la primera ejecución de Tumblr sea pequeña. Una simulación muestra mensajes del extractor sin guardar medios, así que puedes detectar una URL incorrecta, una pantalla de acceso o un alcance demasiado amplio antes de crear archivos.
Usa una forma de comando como la siguiente y sustituye la URL por un destino público que tengas permiso para inspeccionar. La salida es evidencia para la siguiente decisión, no una promesa de que cada publicación contenga un archivo.
Cuando la simulación sea coherente, elige una carpeta de prueba vacía y repite la misma URL sin `--simulate`. Mantén el destino separado de un archivo existente en esta primera pasada. Así puedes comparar mensajes y archivos y eliminar el resultado de prueba sin tocar una colección cuidada.
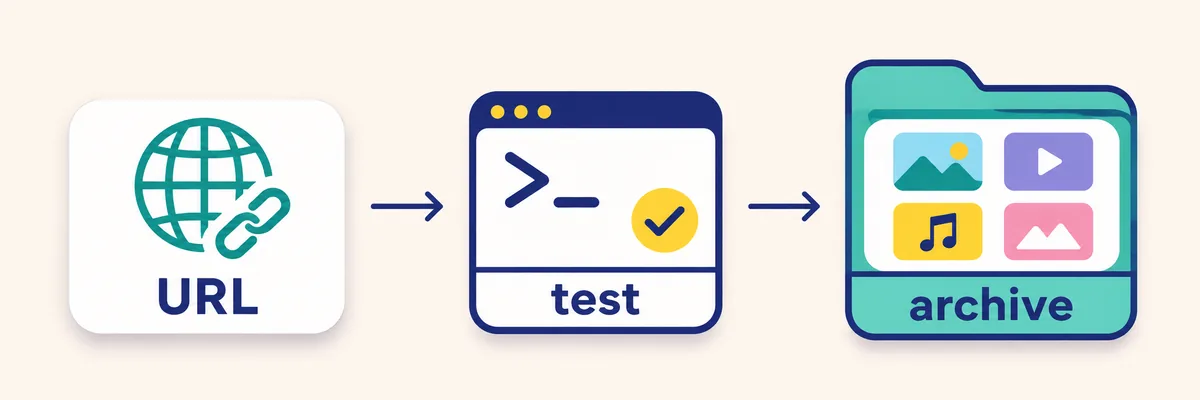
Un trabajo repetible en Tumblr tiene tres etapas visibles: elegir una URL, simular el resultado y archivar una muestra.
Lee la salida de simulación
Busca el nombre del extractor, el blog o identificador de publicación, las URL de medios y cualquier aviso de autenticación. Si aparece un resultado vacío, no añadas cookies ni cambies muchos ajustes de inmediato. Comprueba primero que la URL sea una forma compatible, que el blog sea público y que tu versión instalada pueda procesar la respuesta actual del sitio.
Usa `--verbose` al diagnosticar una URL nueva y quítalo en ejecuciones rutinarias.
Usa `--range` o un alcance reducido antes de archivar un blog completo.
Descarga blogs, etiquetas, publicaciones y búsquedas
Descargar un blog es el flujo más habitual, pero no debe ser la opción automática para cada tarea. Si necesitas una imagen concreta, usa su publicación. Si estás reuniendo un tema, usa una etiqueta y un rango pequeño. Si exploras un asunto desconocido, usa la búsqueda para descubrir publicaciones y conviértelas después en trabajos de publicaciones o blogs que puedas repetir.
El extractor puede encontrar más que fotos. Las publicaciones de vídeo y audio pueden tener un comportamiento distinto; las de texto, cita o respuesta pueden no producir ningún archivo; y los reblogs pueden aportar metadatos que no quieres en un nombre. La simulación debe mostrar qué tipos aparecen antes de escribir un filtro. Un filtro pensado solo para fotos puede hacer que un blog mixto parezca vacío aunque el extractor funcione.
Para un blog grande, divide la tarea en puntos de control. Ejecuta un rango inicial, revisa la carpeta, guarda el archivo de historial y amplía solo después. Si aparece un error de red, los nombres estables y el historial permiten continuar sin tratar todos los elementos anteriores como nuevos.
Secuencia práctica
Primero valida una publicación. Después valida el alcance del blog o etiqueta. Luego decide si necesitas cookies. Añade la distribución y el historial al final y repite solo cuando la muestra sea comprensible. Esta secuencia separa problemas de análisis y de acceso y evita que una carpeta enorme esconda el error original.
URL de publicación: mejor para comprobar un elemento.
URL de blog: mejor para un archivo de autor o colección.
URL de etiqueta: mejor para una muestra temática acotada.
URL de búsqueda: mejor para descubrir, no para una clave de archivo inmutable.
Qué es un buen resultado
Un buen resultado se puede explicar: sabes qué URL lo produjo, por qué la cantidad de archivos parece razonable, qué tipos se incluyeron y dónde se escribió el archivo. Descargar muchos archivos sin poder repetir ni auditar la tarea es un flujo arriesgado aunque la carpeta parezca completa.
Repetibilidad
Controla configuración, nombres e historial
Pasa las decisiones estables a la configuración de gallery-dl cuando entiendas el comando de prueba. Un archivo de configuración puede definir la carpeta de Tumblr, los campos del nombre, un historial de descargas y una pausa prudente. Centralizar estas decisiones reduce las diferencias entre una ejecución manual y otra programada.
Los nombres de Tumblr deben responder a tres preguntas: qué blog produjo el archivo, qué publicación o identificador está implicado y qué número distingue varios medios. Usa la guía de plantillas para descubrir palabras clave en vez de adivinar campos. Si un campo no existe para un tipo de publicación, elige un respaldo legible en lugar de depender de separadores vacíos o de un texto completo.
El historial registra identificadores procesados; no es una copia de seguridad de los medios. Guárdalo junto a la configuración, inclúyelo en tu plan de copias y no lo publiques si contiene datos sensibles de URL. Si cambias la carpeta o el patrón de nombres, conserva el mismo historial solo si quieres seguir omitiendo los mismos elementos lógicos.
Cambiar una carpeta no cambia la identidad del historial. Decide si una publicación debe seguir omitida antes de mover archivos o dividir un blog en nuevos destinos.
Acceso
Usa cookies solo cuando Tumblr las necesite
Las páginas públicas de Tumblr deben ser la primera prueba. Si el navegador ve una página pero gallery-dl recibe un error de acceso, puede faltar una cookie de sesión, un estado de consentimiento o una respuesta que cambia después de cargar el navegador. La ayuda de cookies del sitio explica cómo exportarlas localmente; sigue ese flujo y entrega el archivo mediante la opción compatible en vez de pegar valores en un comando o en un informe público.
Las cookies no convierten una página privada en pública ni garantizan que una publicación pueda archivarse. Caducan, reflejan los permisos de la cuenta que las creó y pueden exponer el acceso si se copian sin cuidado. Guarda el archivo con permisos restrictivos, fuera de una carpeta pública, y elimínalo cuando termine la prueba.
Cuando falle un comando con cookies, compáralo con una simulación pública. Si también falla la prueba pública, probablemente el problema sea la URL, la versión, la red o el límite de solicitudes, no la autenticación. Esta comparación evita rotar credenciales cuando el extractor necesita una actualización o un ritmo más lento.
Lista de acceso prudente
Confirma primero la URL pública. Exporta solo las cookies necesarias. Ejecuta una simulación de una publicación. No subas el archivo al repositorio ni lo dejes en el directorio del proyecto. Revoca o borra la sesión cuando ya no la necesites.
Nunca pegues cabeceras de cookies en tutoriales, registros o incidencias.
No publiques contenido autenticado de otra persona sin permiso.
Usa el alcance autenticado mínimo que resuelva la tarea.
Control
Añade filtros, pausas y límites responsables
Un archivo de Tumblr se administra mejor cuando el comando expresa lo que buscas. Usa un rango para la primera muestra, un filtro de fecha o publicación cuando los metadatos lo permitan y una condición de tipo cuando el contenido mixto no sea útil. Verifica cada condición con una simulación porque un filtro que no coincide puede parecer un extractor roto.
Un ritmo respetuoso protege tu flujo y el servicio. Una pausa breve, un rango moderado y una condición de parada son mejores valores iniciales que varios procesos completos en paralelo. Si Tumblr devuelve un límite o un error temporal, detente, conserva los registros y reintenta más tarde con un alcance menor. No intentes superar un bloqueo rotando cuentas o enviando solicitudes agresivas.
La capacidad técnica de guardar un archivo no equivale a permiso para republicarlo. Revisa las condiciones del creador, las políticas de Tumblr y la licencia o copyright del medio. Mantén fuera de los archivos públicos el material privado o sensible y conserva la URL de origen cuando necesites procedencia.
Control
Ayuda
Qué verificar
Rango pequeño
Limita la primera escritura
El rango coincide con el orden esperado
Filtro de tipo
Evita texto o medios irrelevantes
La simulación muestra coincidencias
Pausa
Reduce picos de tráfico
El trabajo sigue siendo práctico
Historial
Omite identificadores conocidos
La ruta es estable y está respaldada
Destino separado
Protege archivos cuidados
La carpeta de prueba se puede borrar
Recuperación
Soluciona fallos habituales de Tumblr
Clasifica el fallo antes de cambiar el comando. Un 404 o resultado vacío puede indicar una URL mal copiada, un blog que cambió de dirección o una ruta que no es compatible. Un 403 o mensaje de inicio de sesión apunta a acceso, consentimiento, cookies o una respuesta de política. Un tiempo de espera o 429 apunta al ritmo, la red o un límite temporal. Cada categoría necesita una corrección distinta.
Para un problema de URL, abre la página en el navegador, copia la dirección canónica y repite una publicación con `--simulate --verbose`. Para un problema de acceso, compara una publicación pública con la sesión autenticada y usa la ayuda de cookies solo si la comparación lo justifica. Para un límite, detén el proceso, espera, reduce el rango y evita trabajos paralelos. Para una cantidad inesperada, revisa tipos, reblogs, recursos del tema y filtros antes de borrar el historial.
Conserva el texto original del error cuando pidas ayuda. Incluye la versión de gallery-dl, el sistema operativo, el comando saneado, la forma de la URL sin tokens privados y si funciona una simulación pública. Nunca adjuntes archivos de cookies ni medios privados a una incidencia pública.
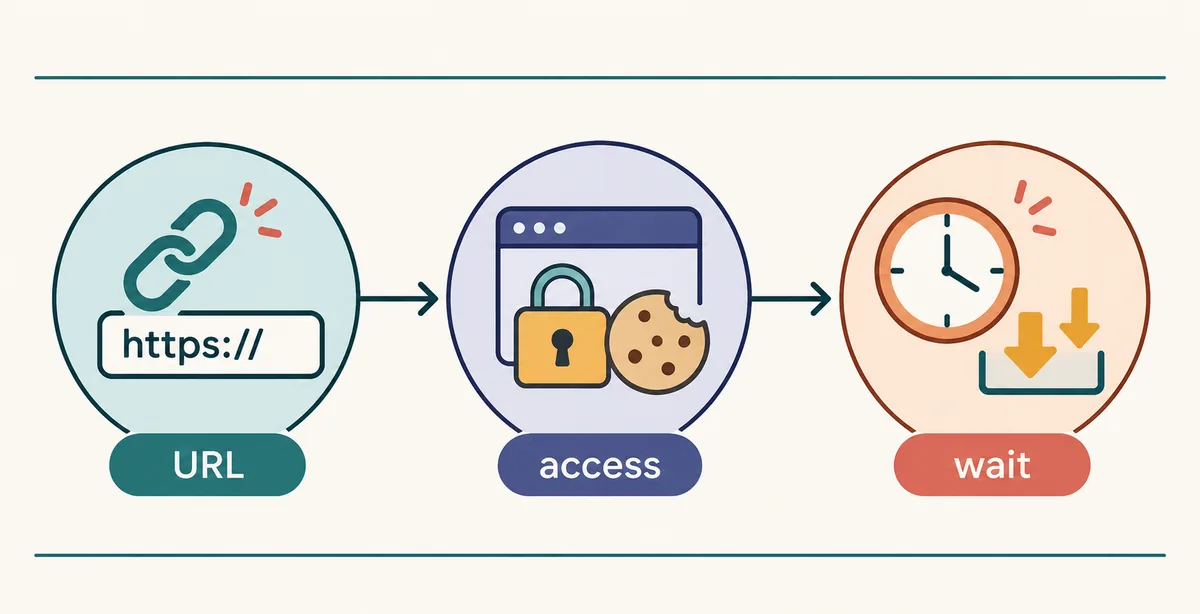
Separa fallos de URL, acceso y límite antes de cambiar la configuración o las credenciales.
Orden de diagnóstico rápido
Comprueba la forma de la URL, prueba una publicación, compara acceso público y autenticado y solo después cambia filtros o destino. Este orden evita convertir un error de formato en un experimento de configuración confuso.
URL: ruta canónica, nombre del blog, ID de publicación y redirección.
Acceso: visibilidad, consentimiento, cookies y cuenta.
Espera: 403/429, tiempo de espera, pausa y ventana de reintento.
Salida: destino, campos de nombre, historial y duplicados.
Preguntas
Preguntas frecuentes sobre gallery-dl Tumblr
Estas respuestas se centran en decisiones que afectan a un trabajo de Tumblr repetible. Las páginas generales enlazadas ofrecen ejemplos más amplios cuando el problema no es específico de Tumblr.
Preguntas frecuentes
Preguntas de gallery-dl Tumblr
¿Puede gallery-dl descargar un blog completo de Tumblr?
Puede procesar una URL pública compatible, pero empieza con simulación y un rango pequeño. Un blog puede mezclar tipos, reblogs y mucho historial, así que usa un destino estable y un archivo antes de ampliarlo.
¿Uso una URL de blog o una etiqueta de Tumblr?
Usa el blog para un autor o colección, la etiqueta para una muestra temática y la publicación para verificar un elemento. La búsqueda sirve para descubrir porque sus resultados cambian entre ejecuciones.
¿Por qué gallery-dl Tumblr devuelve un resultado vacío?
Comprueba forma de URL, visibilidad, versión y salida de simulación. Puede ser una ruta incorrecta, un estado no compatible, un filtro sin coincidencias o una respuesta que exige acceso.
¿Necesito cookies para descargar desde Tumblr?
No para todas las páginas públicas. Úsalas solo si la comparación pública y el error muestran que hace falta una sesión. Mantén el archivo privado; las cookies no conceden permiso sobre contenido privado.
¿Cómo evito descargar dos veces la misma publicación?
Configura un historial estable y consérvalo con el trabajo. Prueba por separado los cambios de carpeta o nombre para entender qué identificadores está omitiendo.
¿Qué hago después de un 429 o un tiempo de espera?
Detén el trabajo, conserva el registro, espera, reduce el rango y añade una pausa prudente. Evita reintentos paralelos y no rotes cuentas para esquivar el límite.