gallery-dl Tumblr : télécharger blogs et publications
Le support gallery-dl Tumblr devient plus simple lorsque vous séparez la portée de l’URL, l’accès et le contrôle des relances. Ce guide explique comment tester un blog public, télécharger un tag ou un billet précis, ajouter des cookies uniquement si nécessaire et garder une archive locale prévisible.
URL de blogTags et rechercheCookiesArchives sans doublons
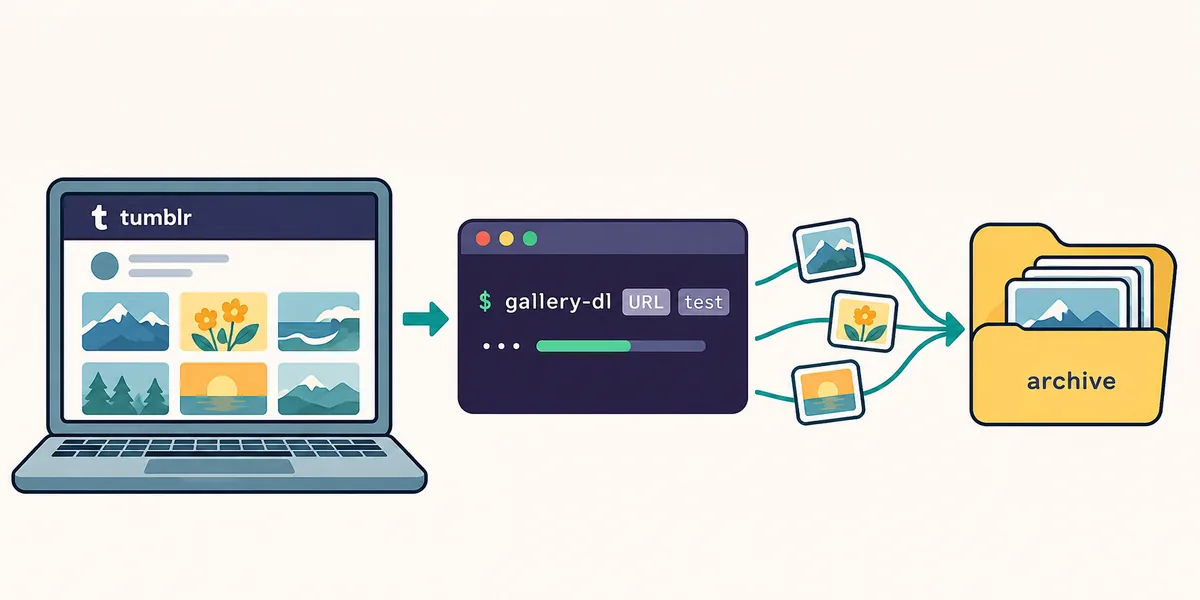
Un flux Tumblr commence par un petit test d’URL et se termine par une archive locale vérifiée.Réponse rapide
Utilisez une URL publique de blog, de tag, de publication ou de recherche Tumblr. Commencez avec gallery-dl --simulate pour voir le résultat sans écrire de fichiers, puis relancez la même URL avec une portée réduite et un dossier connu. Ajoutez les cookies du navigateur seulement si Tumblr demande une session authentifiée et gardez une archive si vous prévoyez de répéter le travail.
Portée
Ce que gallery-dl Tumblr traite
L’extracteur gallery-dl Tumblr est conçu pour les URL de type blog plutôt que pour un point d’image unique. Il reconnaît les blogs Tumblr, les sous-domaines personnalisés, les liens de billets et les chemins de collection. Il distingue aussi les billets photo, vidéo, audio, citation, lien, réponse, discussion et recherche. Un même blog peut donc mélanger texte et médias alors que vous ne souhaitez peut-être conserver qu’un seul type.
Pensez à gallery-dl Tumblr comme à un flux d’archivage contrôlé. L’URL définit la portée, l’extracteur transforme cette portée en messages et médias, et votre configuration choisit les dossiers, les noms et le traitement des éléments déjà connus. La commande ne donne pas accès aux billets privés, ne contourne pas une connexion et ne décide pas si vous avez le droit de conserver l’œuvre d’autrui.
Cette page est plus précise que la liste des sites compatibles et plus ciblée que le guide général. Les pages liées couvrent l’installation, l’export de cookies, les mots-clés de noms et l’entretien des archives ; ici, les décisions propres à Tumblr sont réunies.
Le bon modèle mental
Traitez une URL Tumblr comme une limite de recherche. Une URL de blog peut être large, un tag thématique, un billet ponctuel et une recherche évolutive. Définissez cette limite avant d’ajouter pagination, filtres ou archivage long.
La portée de l’URL choisit ce que l’extracteur découvre.
La simulation confirme ce qui serait découvert.
La configuration contrôle chemins, noms, délais et archives.
Les permissions et les règles Tumblr restent déterminantes.
Choix de l’URL
Choisir le bon type d’URL Tumblr
Commencez avec l’URL la plus étroite qui répond à votre question. Un billet sert à vérifier l’analyse d’un élément précis. Une URL de blog convient au suivi des médias d’un auteur. Un tag ou une recherche est plus large et moins stable puisque de nouveaux résultats peuvent apparaître. Si une URL mobile contient des paramètres de suivi, retirez-les uniquement après avoir vérifié que la portée reste identique.
Les blogs Tumblr peuvent avoir plusieurs formes. Un lien `tumblr.com/blog/nom`, un sous-domaine `nom.tumblr.com` et un lien permanent peuvent désigner le même blog, mais ne sont pas aussi pratiques pour un test. Préférez la forme courte et canonique et notez l’URL d’origine.
Une image visible dans un thème n’est pas forcément un média de billet. Les avatars, recommandations, intégrations externes et éléments décoratifs peuvent se mélanger. Lisez les lignes de simulation, les identifiants, les URL de médias et les types de billets avant d’écrire un filtre.
Portée
Premier usage
Point de vigilance
Billet unique
Vérifier analyse et droits
Peut ne produire aucun fichier
Blog
Archiver un auteur
Peut devenir volumineux
Tag
Échantillon thématique
Les résultats évoluent
Recherche
Découvrir des candidats
Difficile à reproduire
Sous-domaine
Flux direct d’un blog
Vérifier qu’il appartient à Tumblr
Une URL pour commencer
Une simulation d’un seul billet donne une preuve plus claire qu’une grosse commande mélangeant thème, reblogs et résultats hors sujet.
Première exécution
Installer et lancer un premier test sécurisé
Installez gallery-dl avec la méthode adaptée à votre environnement Python ou à vos paquets. Le guide d’installation présente les choix ; lorsque `gallery-dl --version` répond, gardez la première exécution Tumblr petite. La simulation affiche les messages de l’extracteur sans enregistrer les médias et révèle une mauvaise URL, une demande de connexion ou une portée trop large.
Utilisez une forme de commande comme ci-dessous en remplaçant l’URL par une cible publique que vous avez le droit d’inspecter. La sortie sert à décider de la suite ; elle ne promet pas que chaque billet possède un fichier.
Après une simulation cohérente, choisissez un dossier de test vide et relancez sans `--simulate`. Séparez-le d’une archive existante afin de comparer messages et fichiers et de supprimer le test sans toucher à une collection importante.
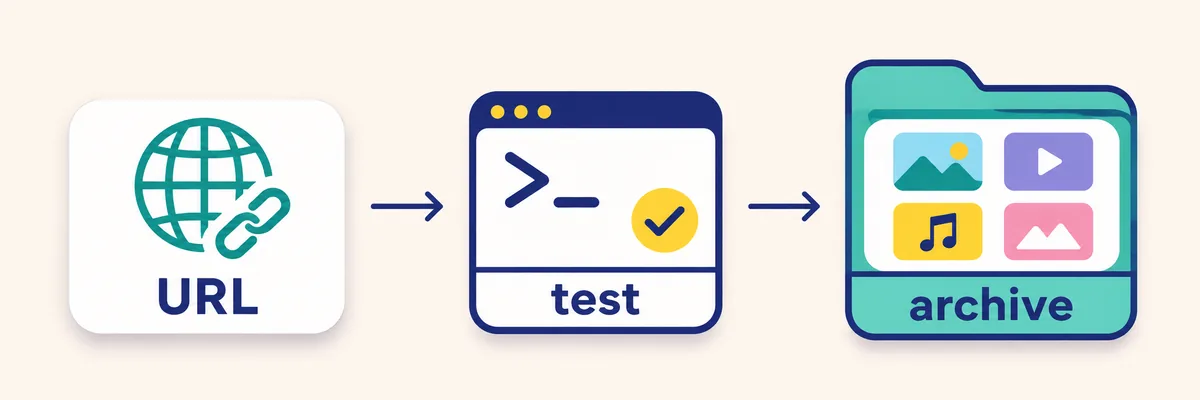
Un travail Tumblr reproductible sélectionne une URL, simule le résultat puis archive un petit échantillon.
Lire la simulation
Repérez le nom de l’extracteur, le blog ou l’identifiant du billet, les URL de médias et les avertissements d’authentification. Un résultat vide ne justifie pas immédiatement l’ajout de cookies. Vérifiez d’abord la forme d’URL, la visibilité du blog et la version installée.
Utilisez `--verbose` pour diagnostiquer une nouvelle URL, puis retirez-le en routine.
Le téléchargement d’un blog est courant, mais ne doit pas être le choix par défaut. Pour une image précise, utilisez son billet. Pour un thème, utilisez un tag avec une petite plage. Pour explorer un sujet, utilisez la recherche pour trouver des candidats puis convertissez-les en URL de billets ou de blogs que vous pourrez répéter.
L’extracteur peut rencontrer autre chose que des photos. Les billets vidéo et audio peuvent avoir un comportement différent ; les billets texte, citation ou réponse peuvent ne produire aucun fichier ; les reblogs peuvent fournir des métadonnées indésirables dans un nom. Vérifiez les types présents en simulation avant d’écrire un filtre.
Pour un grand blog, travaillez par points de contrôle. Lancez une première plage, inspectez le dossier et l’archive, puis élargissez. Après une erreur réseau, des noms stables et une archive permettent de reprendre sans traiter les anciens éléments comme nouveaux.
Séquence pratique
Validez d’abord un billet, puis la portée du blog ou du tag. Décidez ensuite si des cookies sont nécessaires, ajoutez enfin destination et archive, puis répétez quand l’échantillon est compris.
Billet : vérifier un élément.
Blog : archive d’un auteur ou d’une collection.
Tag : échantillon thématique limité.
Recherche : découverte, pas clé d’archive immuable.
Un bon résultat
Un bon résultat est explicable : URL d’origine, nombre plausible de fichiers, types inclus et dossier connu. Une grande quantité sans répétabilité ni audit reste un flux risqué.
Répétabilité
Maîtriser configuration, noms et archives
Une fois le test compris, placez les choix stables dans la configuration gallery-dl. Elle peut définir le dossier Tumblr, les champs de nom, une archive et un délai modéré. Une configuration revue réduit les différences entre exécution manuelle et tâche planifiée.
Un nom Tumblr doit indiquer le blog, le billet ou l’identifiant et le numéro qui distingue plusieurs médias. Utilisez le guide des modèles pour trouver les mots-clés plutôt que de les deviner. Si un champ manque pour un type de billet, choisissez un repli lisible.
Une archive enregistre des identifiants traités ; elle ne remplace pas une sauvegarde des médias. Gardez-la avec la configuration, sauvegardez-la et ne la publiez pas si elle révèle des données d’URL. Conservez-la après un changement de dossier seulement si vous voulez ignorer les mêmes éléments logiques.
Changer le dossier ne change pas l’identité de l’archive. Décidez si le même billet doit rester ignoré avant de déplacer les fichiers.
Accès
Utiliser les cookies seulement si Tumblr les demande
Les pages publiques Tumblr doivent être votre premier test. Si le navigateur voit une page mais que gallery-dl renvoie une erreur d’accès, il peut manquer un cookie de session, un consentement ou une réponse différente après le chargement. L’aide cookies du site explique l’export local ; utilisez l’option gallery-dl prévue au lieu de coller des valeurs dans une commande ou une issue publique.
Un cookie ne rend pas une page privée publique et ne garantit pas qu’un billet puisse être archivé. Il expire, reflète les droits du compte et peut exposer l’accès s’il est copié. Protégez le fichier, gardez-le hors d’un dossier public et supprimez-le après le test.
En cas d’échec avec cookie, comparez une simulation publique. Si elle échoue aussi, la cause est probablement l’URL, la version, le réseau ou le rythme plutôt que l’authentification.
Liste de contrôle prudente
Confirmez l’URL publique, exportez uniquement les cookies utiles, simulez un billet, ne commitez jamais le fichier et supprimez la session lorsqu’elle n’est plus nécessaire.
Ne collez jamais de cookies dans un tutoriel ou un journal.
Ne publiez pas de contenu authentifié sans autorisation.
Utilisez la portée authentifiée minimale.
Contrôle
Ajouter filtres, délais et limites responsables
Un archivage Tumblr est plus clair lorsque la commande décrit le besoin. Utilisez une plage pour l’échantillon initial, un filtre de date ou de billet quand les métadonnées le permettent et une condition de type si le contenu mixte est inutile. Vérifiez chaque condition en simulation : un filtre sans correspondance ressemble à un extracteur cassé.
Un délai court, une plage modérée et une condition d’arrêt protègent le flux et le service. Si Tumblr renvoie une limite ou une erreur temporaire, arrêtez, gardez les journaux et réessayez plus tard avec une portée réduite. N’essayez pas de contourner un blocage en changeant de compte ou en multipliant les requêtes.
La possibilité technique d’enregistrer un fichier n’est pas une permission de le republier. Vérifiez les conditions de l’auteur, les règles Tumblr et la licence ou le droit d’auteur. Écartez des archives publiques les contenus privés ou sensibles et gardez l’URL source si la provenance est importante.
Contrôle
Bénéfice
À vérifier
Petite plage
Limite la première écriture
Ordre attendu cohérent
Type de billet
Évite texte ou médias inutiles
Au moins une correspondance simulée
Délai
Réduit les pics
Le travail reste réaliste
Archive
Ignore les identifiants connus
Chemin stable et sauvegardé
Dossier séparé
Protège la collection
Test supprimable
Récupération
Dépanner les échecs Tumblr courants
Classez l’échec avant de modifier la commande. Un 404 ou un résultat vide peut venir d’une URL mal copiée, d’un blog déplacé ou d’un chemin non pris en charge. Un 403 ou une demande de connexion indique accès, consentement, cookies ou réponse de politique. Un délai d’attente ou un 429 indique rythme, réseau ou limite temporaire. Chaque catégorie demande une action différente.
Pour une URL, ouvrez la page dans un navigateur, copiez l’adresse canonique et testez un billet avec `--simulate --verbose`. Pour l’accès, comparez un billet public et la session authentifiée, puis utilisez l’aide cookies seulement si la comparaison le justifie. Pour une limite, arrêtez, attendez, réduisez la plage et évitez les tâches parallèles. Pour un nombre inattendu, inspectez types, reblogs, éléments de thème et filtres avant de supprimer l’archive.
Gardez le message d’erreur original pour demander de l’aide. Indiquez version gallery-dl, système, commande nettoyée, forme d’URL sans jetons privés et résultat d’une simulation publique. N’envoyez jamais de cookies ni de médias privés.
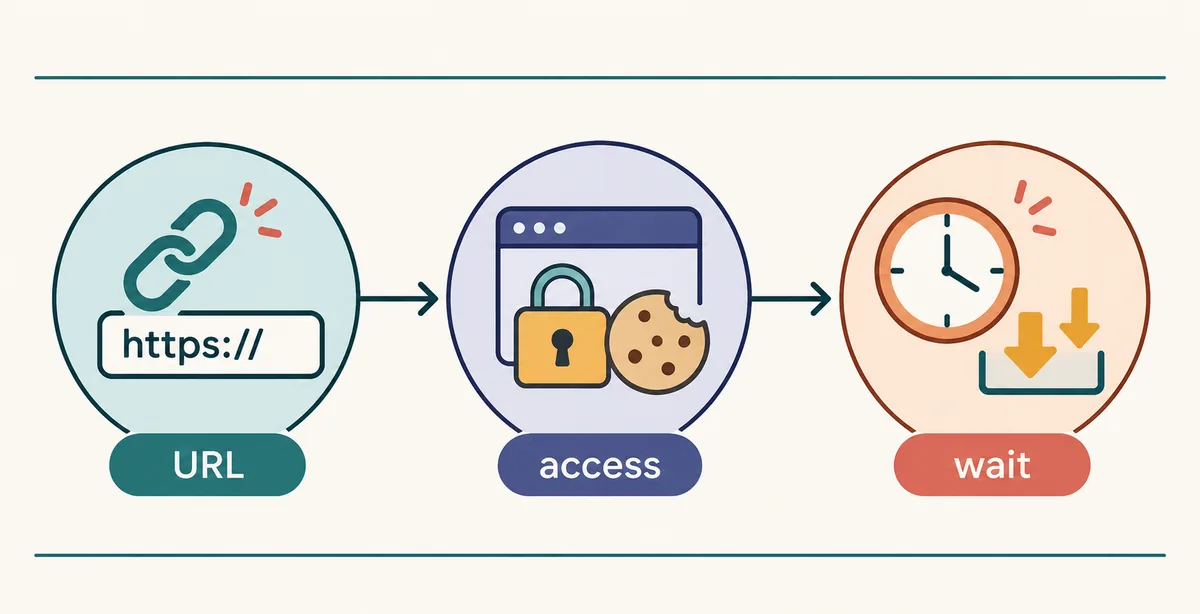
Séparez URL, accès et limitation avant de changer configuration ou identifiants.
Ordre de diagnostic
Vérifiez la forme de l’URL, testez un billet, comparez accès public et authentifié, puis seulement les filtres ou la sortie. Cet ordre évite de transformer une faute de format en expérience confuse.
URL : chemin canonique, blog, ID et redirection.
Accès : visibilité, consentement, cookies et compte.
Attente : 403/429, délai, pause et fenêtre de reprise.
Sortie : dossier, champs de nom, archive et doublons.
Questions
FAQ gallery-dl Tumblr
Ces réponses couvrent les décisions d’un travail Tumblr répétable. Les guides liés donnent davantage d’exemples lorsque le problème n’est pas propre à Tumblr.
Questions fréquentes
Questions gallery-dl Tumblr
gallery-dl peut-il télécharger un blog Tumblr entier ?
Il peut traiter une URL publique compatible, mais commencez par une simulation et une petite plage. Un blog peut mélanger types, reblogs et historique ; utilisez donc un dossier stable et une archive avant d’élargir.
Faut-il une URL de blog ou de tag Tumblr ?
Utilisez le blog pour un auteur, le tag pour un échantillon thématique et le billet pour vérifier un élément. La recherche convient à la découverte, car ses résultats changent.
Pourquoi gallery-dl Tumblr renvoie-t-il un résultat vide ?
Vérifiez forme d’URL, visibilité, version et sortie de simulation. Il peut s’agir d’un mauvais chemin, d’un état non supporté, d’un filtre vide ou d’un besoin d’accès.
Les cookies sont-ils nécessaires pour Tumblr ?
Pas pour toutes les pages publiques. Utilisez-les seulement si la comparaison publique et l’erreur montrent qu’une session est requise. Gardez le fichier privé : il ne donne pas de droit sur un contenu privé.
Comment éviter les doublons Tumblr ?
Configurez une archive stable et gardez-la avec la tâche. Testez séparément les changements de dossier ou de nom pour savoir quels identifiants sont ignorés.
Que faire après un 429 ou un délai Tumblr ?
Arrêtez, gardez le journal, attendez, réduisez la plage et ajoutez un délai prudent. Évitez les relances parallèles et le changement de compte pour contourner une limite.