Il supporto gallery-dl Tumblr è più facile da gestire quando separi portata dell’URL, accesso e controllo delle esecuzioni ripetute. Questa guida mostra come testare un blog pubblico, scaricare un tag o un post preciso, aggiungere cookie solo quando servono e mantenere un archivio locale prevedibile.
URL di blogTag e ricercaCookieArchivi senza duplicati
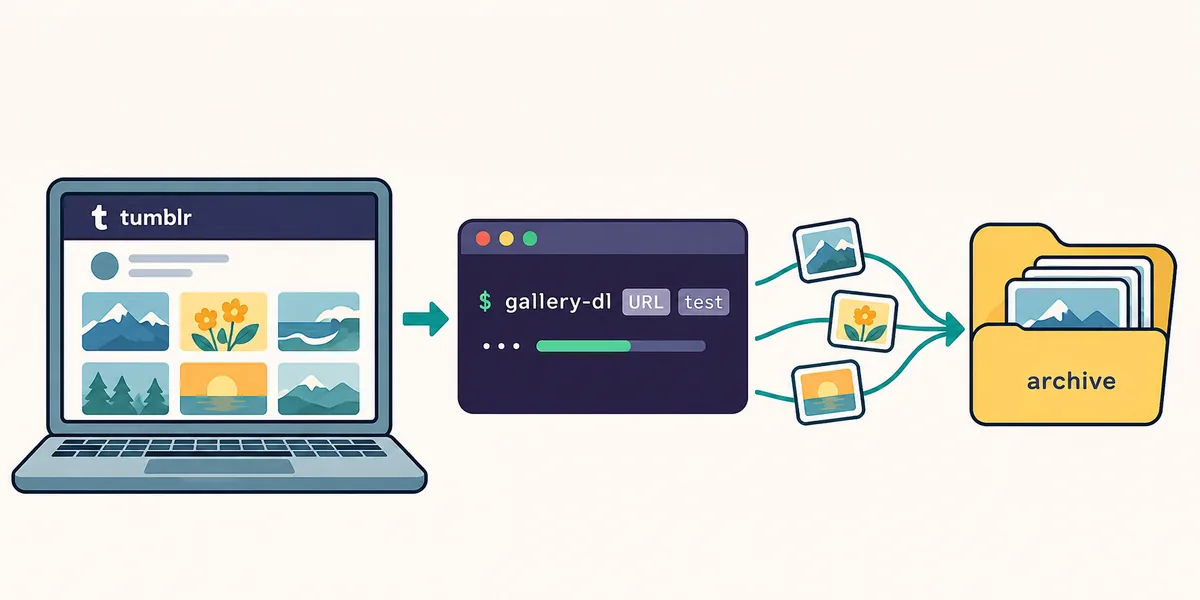
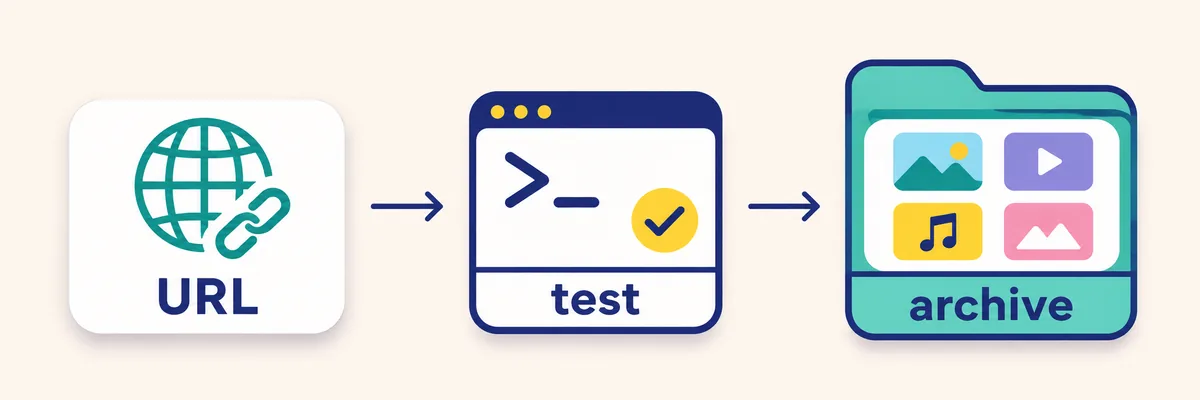
Un flusso Tumblr inizia con un piccolo test e termina con un archivio locale verificato.Risposta rapida
Usa una URL pubblica di blog, tag, post o ricerca Tumblr. Inizia con gallery-dl --simulate per vedere il risultato senza scrivere file, poi ripeti la stessa URL con un intervallo ridotto e una destinazione nota. Aggiungi i cookie del browser solo se Tumblr richiede una sessione autenticata e conserva un archivio se prevedi di ripetere il lavoro.
Ambito
Cosa gestisce gallery-dl Tumblr
L’estrattore gallery-dl Tumblr è pensato per URL con struttura di blog, non per un singolo endpoint generico di immagini. Riconosce blog Tumblr, sottodomini personalizzati, link a post e percorsi di raccolta. Gestisce anche post foto, video, audio, citazioni, link, risposte, chat e risultati di ricerca. Lo stesso blog può quindi mescolare testo e media, mentre tu potresti voler conservare un solo tipo.
Considera gallery-dl Tumblr un flusso di archiviazione controllato. La URL stabilisce l’ambito, l’estrattore lo trasforma in messaggi e media, e la configurazione decide cartelle, nomi e elementi già noti. Il comando non concede accesso a post privati, non aggira il login e non stabilisce se puoi conservare il lavoro di altri.
Questa pagina è più specifica della lista dei siti supportati e più mirata della guida generale. Installazione, esportazione dei cookie, parole chiave per i nomi e manutenzione dell’archivio sono disponibili nelle pagine collegate; qui raccogliamo le decisioni proprie di Tumblr.
Il modello mentale utile
Tratta una URL Tumblr come il confine della ricerca. Una URL di blog può essere ampia, una di tag tematica, una di post serve per un controllo singolo e una di ricerca cambia nel tempo. Definisci il confine prima di aggiungere paginazione, filtri o un archivio lungo.
L’ambito della URL decide cosa trova l’estrattore.
La simulazione conferma cosa verrebbe trovato.
La configurazione controlla percorsi, nomi, pause e archivi.
Permessi e regole Tumblr restano vincolanti.
Scelta della URL
Scegli il tipo giusto di URL Tumblr
Inizia dalla URL più piccola che risponde alla domanda. Un post serve a verificare l’analisi di un elemento. Un blog è adatto all’archivio di un autore. Tag e ricerca sono più ampi e meno stabili perché i risultati cambiano. Se copi una URL dal telefono, rimuovi i parametri di tracciamento solo dopo aver controllato che il confine resti uguale.
I blog Tumblr possono avere forme diverse. `tumblr.com/blog/nome`, `nome.tumblr.com` e un permalink possono indicare lo stesso blog, ma non sono ugualmente comodi per un test. Preferisci la forma breve e quasi canonica e annota la URL originale.
Un’immagine mostrata da un tema non è necessariamente un media del post. Avatar, suggerimenti, embed esterni e risorse decorative possono essere mescolati. Controlla nella simulazione ID, URL media e tipo di post prima di scrivere un filtro.
Ambito
Primo uso
Attenzione
Post singolo
Controllo parser e permesso
Può non avere media scaricabili
Blog
Archivio di un autore
Può diventare molto grande
Tag
Campione tematico
I risultati cambiano
Ricerca
Scoperta di candidati
Difficile da riprodurre
Sottodominio
Flusso diretto di blog
Verifica che appartenga a Tumblr
Parti da una URL
Una simulazione di un solo post offre prove più chiare di un comando grande che mescola tema, reblog e risultati non pertinenti.
Prima esecuzione
Installa ed esegui un primo test sicuro
Installa gallery-dl con il metodo adatto al tuo ambiente Python o ai tuoi pacchetti. La guida di installazione illustra le opzioni; quando `gallery-dl --version` risponde, mantieni piccola la prima esecuzione Tumblr. La simulazione mostra i messaggi dell’estrattore senza salvare media e fa emergere URL errate, login o ambiti troppo ampi.
Usa una forma di comando come negli esempi e sostituisci la URL con una destinazione pubblica che puoi consultare. L’output serve per decidere il passo successivo, non garantisce che ogni post contenga un file.
Quando la simulazione è coerente, scegli una cartella di test vuota e ripeti senza `--simulate`. Tieni la destinazione separata da un archivio esistente per confrontare messaggi e file e poter eliminare il test senza toccare la raccolta principale.
Un lavoro Tumblr ripetibile seleziona una URL, simula il risultato e archivia un piccolo campione.
Leggere la simulazione
Cerca il nome dell’estrattore, il blog o l’ID del post, gli URL dei media e gli avvisi di autenticazione. Un risultato vuoto non richiede subito cookie. Controlla prima formato della URL, visibilità del blog e versione installata.
Usa `--verbose` per diagnosticare una URL nuova e rimuovilo nel lavoro normale.
Scaricare un blog è comune, ma non deve essere il primo passo per ogni attività. Per una singola immagine usa il post. Per un tema usa un tag con intervallo piccolo. Per esplorare usa la ricerca per trovare candidati e trasformali poi in lavori di post o blog ripetibili.
L’estrattore può incontrare più delle foto. Video e audio possono comportarsi diversamente; post di testo, citazione o risposta possono non produrre file; i reblog possono aggiungere metadati indesiderati al nome. Controlla i tipi nella simulazione prima di filtrare.
Per un blog grande lavora per checkpoint. Esegui un intervallo iniziale, controlla cartella e archivio e amplia solo dopo. In caso di errore di rete, nomi stabili e archivio permettono di riprendere senza trattare gli elementi già visti come nuovi.
Sequenza pratica
Valida prima un post, poi l’ambito di blog o tag. Decidi sui cookie, aggiungi destinazione e archivio e ripeti soltanto quando il campione è chiaro. Così separi problemi di analisi e di accesso.
Post: controllo di un elemento.
Blog: archivio di autore o raccolta.
Tag: campione tematico limitato.
Ricerca: scoperta, non chiave di archivio immutabile.
Un buon risultato
Un buon risultato è spiegabile: URL di origine, quantità plausibile, tipi inclusi e cartella nota. Molti file senza ripetibilità o verifica non formano un flusso sicuro.
Ripetibilità
Gestire configurazione, nomi e archivi
Quando il test è chiaro, sposta le scelte stabili nella configurazione gallery-dl. Può definire directory Tumblr, campi del nome, archivio dei download e una pausa moderata. Centralizzare le scelte riduce le differenze tra esecuzioni manuali e pianificate.
Un nome Tumblr dovrebbe mostrare blog, post o ID e il numero che distingue più media. Usa la guida dei modelli per trovare le parole chiave invece di indovinare i campi. Se un campo manca per un tipo di post, scegli un fallback leggibile.
L’archivio registra gli ID elaborati, non sostituisce il backup dei media. Conservalo con la configurazione, includilo nei backup e non pubblicarlo se rivela dati di URL. Dopo un cambio di cartella o nome, riusa lo stesso archivio solo se vuoi saltare gli stessi elementi logici.
Cambiare cartella non cambia l’identità dell’archivio. Decidi se lo stesso post deve restare escluso prima di spostare i file.
Accesso
Usare i cookie solo quando Tumblr li richiede
Le pagine Tumblr pubbliche devono essere il primo test. Se il browser vede la pagina ma gallery-dl restituisce un errore di accesso, può mancare un cookie di sessione, il consenso o una risposta diversa dopo il caricamento. L’aiuto cookie spiega l’esportazione locale; passa il file all’opzione gallery-dl invece di incollare valori in un comando o in una issue pubblica.
I cookie non rendono pubblica una pagina privata e non garantiscono il diritto di archiviarla. Scadono, riflettono i permessi dell’account e possono esporre l’accesso se copiati. Proteggi il file, tienilo fuori dalle cartelle pubbliche e cancellalo dopo il test.
Se il comando con cookie fallisce, confrontalo con una simulazione pubblica. Se fallisce anche quella, la causa è probabilmente URL, versione, rete o ritmo, non autenticazione.
Controllo prudente dell’accesso
Conferma la URL pubblica, esporta solo i cookie necessari, simula un post, non committare il file e rimuovi la sessione quando non serve più.
Non incollare mai header cookie in tutorial, log o issue.
Non pubblicare contenuti autenticati senza permesso.
Usa il minimo ambito autenticato necessario.
Controllo
Aggiungere filtri, pause e limiti responsabili
Un archivio Tumblr è più gestibile quando il comando esprime il risultato desiderato. Usa un intervallo per il primo campione, un filtro data o post quando i metadati lo permettono e una condizione di tipo se il contenuto misto non serve. Verifica ogni condizione con la simulazione: un filtro senza corrispondenze sembra un estrattore rotto.
Una pausa breve, un intervallo moderato e un criterio di arresto sono preferibili a più processi completi in parallelo. Se Tumblr restituisce un limite o un errore temporaneo, fermati, conserva i log e riprova più tardi con un ambito minore. Non aggirare un blocco cambiando account o inviando richieste aggressive.
La possibilità tecnica di salvare un file non è il permesso di ripubblicarlo. Controlla condizioni dell’autore, regole Tumblr e licenza o copyright. Tieni fuori dagli archivi pubblici materiale privato o sensibile e conserva la URL sorgente quando serve la provenienza.
Controllo
Vantaggio
Verifica
Intervallo piccolo
Limita la prima scrittura
Ordine previsto coerente
Tipo di post
Evita contenuti inutili
La simulazione trova corrispondenze
Pausa
Riduce i picchi
Il lavoro resta pratico
Archivio
Salta ID noti
Percorso stabile e copiato
Destinazione separata
Protegge la raccolta
Cartella di test eliminabile
Recupero
Risoluzione degli errori Tumblr più comuni
Classifica l’errore prima di cambiare il comando. Un 404 o un risultato vuoto può significare URL copiata male, blog spostato o percorso non supportato. Un 403 o la richiesta di login indica accesso, consenso, cookie o una risposta di policy. Timeout o 429 indicano ritmo, rete o limite temporaneo. Ogni categoria richiede una correzione diversa.
Per un problema di URL, apri la pagina nel browser, copia un indirizzo canonico e prova un post con `--simulate --verbose`. Per l’accesso, confronta un post pubblico con la sessione autenticata e usa l’aiuto cookie solo se il confronto lo giustifica. Per un limite, fermati, aspetta, riduci l’intervallo ed evita lavori paralleli. Per un numero inatteso, controlla tipi, reblog, elementi del tema e filtri prima di eliminare l’archivio.
Conserva il testo originale dell’errore quando chiedi aiuto. Indica versione gallery-dl, sistema operativo, comando senza segreti, forma URL senza token privati e se una simulazione pubblica funziona. Non allegare mai cookie o media privati.
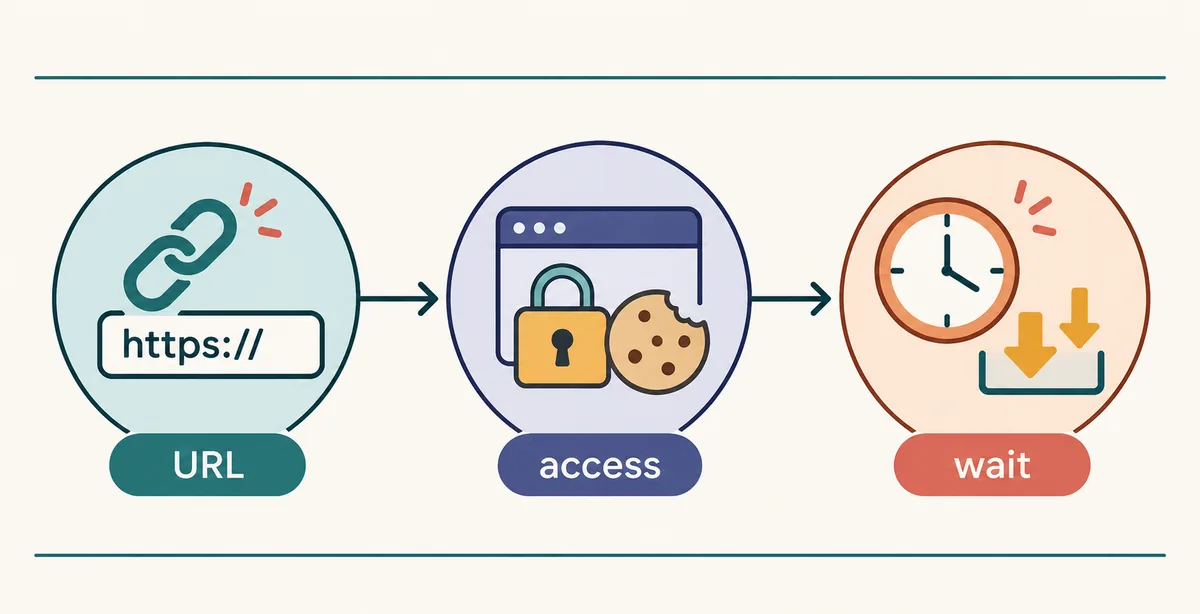
Separa URL, accesso e limiti prima di modificare configurazione o credenziali.
Ordine di diagnosi rapido
Controlla la forma della URL, prova un post, confronta accesso pubblico e autenticato e solo dopo cambia filtri o uscita. Così un errore di formato non diventa un esperimento confuso.
URL: percorso canonico, blog, ID e redirect.
Accesso: visibilità, consenso, cookie e account.
Attesa: 403/429, timeout, pausa e finestra di riprova.
Uscita: cartella, campi del nome, archivio e duplicati.
Domande
FAQ gallery-dl Tumblr
Le risposte riguardano le decisioni per un lavoro Tumblr ripetibile. Le pagine collegate offrono esempi generali per problemi non specifici della piattaforma.
Domande frequenti
Domande su gallery-dl Tumblr
gallery-dl può scaricare un intero blog Tumblr?
Può elaborare una URL pubblica supportata, ma inizia con simulazione e intervallo piccolo. Un blog può contenere molti tipi, reblog e storico; usa destinazione stabile e archivio prima di ampliare.
Uso una URL di blog o di tag Tumblr?
Blog per autore o raccolta, tag per un campione tematico e post per verificare un elemento. La ricerca serve alla scoperta perché i risultati cambiano.
Perché gallery-dl Tumblr restituisce un risultato vuoto?
Controlla formato URL, visibilità, versione e output della simulazione. Può essere percorso errato, stato non supportato, filtro vuoto o accesso richiesto.
Servono cookie per i download Tumblr?
Non per ogni pagina pubblica. Usali solo se confronto pubblico ed errore mostrano che serve una sessione. Proteggi il file: i cookie non danno diritti sui contenuti privati.
Come evito di scaricare due volte lo stesso post Tumblr?
Configura un archivio stabile e conservalo con il lavoro. Prova separatamente cambi di cartella o nome per capire quali ID vengono saltati.
Cosa faccio dopo un 429 o un timeout Tumblr?
Fermati, conserva il log, aspetta, riduci l’intervallo e riprova con una pausa moderata. Evita tentativi paralleli e cambi di account per eludere il limite.