覚えておきたい考え方
TumblrのURLを検索範囲の境界として扱います。ブログURLは広く、タグURLは話題に絞られ、投稿URLは一件の確認に向き、検索URLは内容が変化します。ページングやフィルター、長時間のアーカイブを追加する前に、その境界を記録してください。
- URLの範囲がExtractorの検出対象を決める。
- シミュレーションで書き込み前の結果を確認する。
- 設定で保存先、名前、待ち時間、アーカイブを管理する。
- 保存の可否は権利とTumblrの規約で決まる。
 gallery-dl.wiki実践ガイド
gallery-dl Tumblrを安全に使うには、URLの範囲、アクセス状態、繰り返し実行の管理を分けて考えます。このページでは公開ブログを試し、タグや投稿を小さく保存し、必要な場合だけCookieを使い、予測しやすいローカルアーカイブを作る手順を説明します。
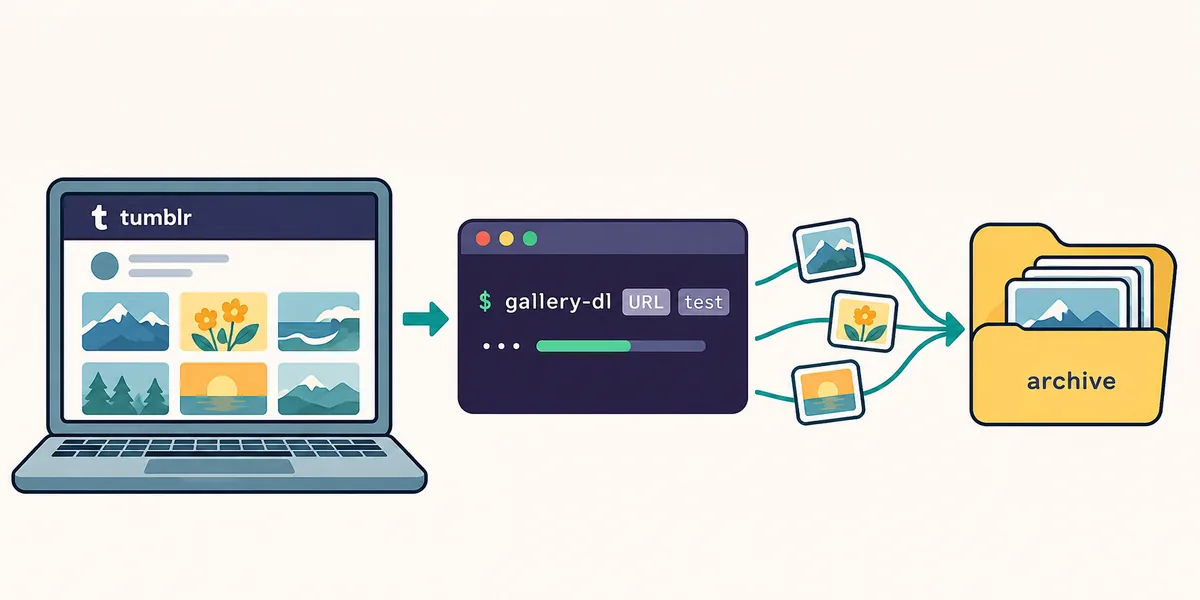
入力にはTumblrの公開ブログ、タグ、投稿、検索URLを使います。最初はgallery-dl --simulateでファイルを書かずに検出結果を確認し、その後同じURLを小さな範囲と既知の保存先で実行します。Tumblrがログイン状態を求める場合だけブラウザーCookieを追加し、再実行する予定ならアーカイブを残します。
gallery-dl TumblrのExtractorは、単一の画像URLではなくブログ形式のURLを処理します。Tumblrのブログ名、カスタムサブドメイン、投稿リンク、コレクションに近いパスを認識し、写真、動画、音声、引用、リンク、回答、チャット、検索結果などの投稿タイプを区別します。同じブログに画像とテキストが混在するため、どのタイプを保存したいかを先に決めることが重要です。
gallery-dl Tumblrは制御可能なアーカイブ作業として考えると分かりやすくなります。URLが対象範囲を決め、Extractorがメディアとメッセージに変換し、設定が保存場所、ファイル名、既知項目の扱いを決めます。コマンドは非公開投稿への権限を与えず、ログインを回避せず、他人の作品を保存してよいかも判断しません。
このページはサイト一覧より具体的で、一般的な使い方ガイドよりTumblrに特化しています。検索語としては gallery-dl Tumblr を使い、インストール、Cookieの書き出し、ファイル名のキーワード、アーカイブ保守は関連ページで補足し、ここではTumblr固有の判断をまとめます。
TumblrのURLを検索範囲の境界として扱います。ブログURLは広く、タグURLは話題に絞られ、投稿URLは一件の確認に向き、検索URLは内容が変化します。ページングやフィルター、長時間のアーカイブを追加する前に、その境界を記録してください。
知りたいことに必要な最小のURLから始めます。投稿URLは特定の項目を解析できるか確認するのに便利です。ブログURLは作者のメディアを継続的に整理する場合に使います。タグURLや検索URLは結果が変わるため、最初は狭い範囲にしてください。スマートフォンの共有URLに追跡パラメーターが付いている場合は、削除後も同じ対象を指すか確認します。
Tumblrのブログは複数の表記で現れます。`tumblr.com/blog/name`、`name.tumblr.com`、投稿のパーマリンクは同じブログを示すことがありますが、テストしやすさは異なります。正規形に近い短いURLを選び、元のURLもメモして後で差分を説明できるようにします。
テーマに表示された画像がすべて投稿メディアとは限りません。アバター、推薦、外部埋め込み、装飾素材が混ざることがあります。シミュレーションの結果行に出るID、メディアURL、投稿タイプを見てからフィルターを作成してください。
| URL範囲 | 最初の用途 | 注意点 |
|---|---|---|
| 単一投稿 | 解析と権限の確認 | メディアがない場合もある |
| ブログ | 作者やコレクションの整理 | 大きな処理になりやすい |
| タグ | 話題の小さなサンプル | 結果が時間で変わる |
| 検索 | 候補の発見 | 再現性が低い |
| カスタムサブドメイン | 直接的なブログ処理 | Tumblrの所有先か確認 |
一件の投稿をシミュレーションする方が、テーマ素材やリブログまで混ぜる大きなコマンドより、正しい対象を確認しやすくなります。
Pythonやパッケージ環境に合う方法でgallery-dlをインストールします。インストールガイドで選択肢を確認し、`gallery-dl --version`が応答したら、Tumblrの最初の実行を小さくします。シミュレーションはメディアを書き込まずにExtractorのメッセージを表示するため、URLの誤り、ログイン画面、広すぎる範囲を早く見つけられます。
次のような形でコマンドを使い、実際に確認する権利のある公開URLへ置き換えます。出力は次の判断材料であり、すべての投稿にファイルがあるという保証ではありません。
シミュレーションが納得できたら、空のテストフォルダーを選び、`--simulate`を外して同じURLを実行します。最初は既存の大切なアーカイブと分けてください。メッセージ数とファイル数を比較でき、不要ならテスト結果だけを削除できます。
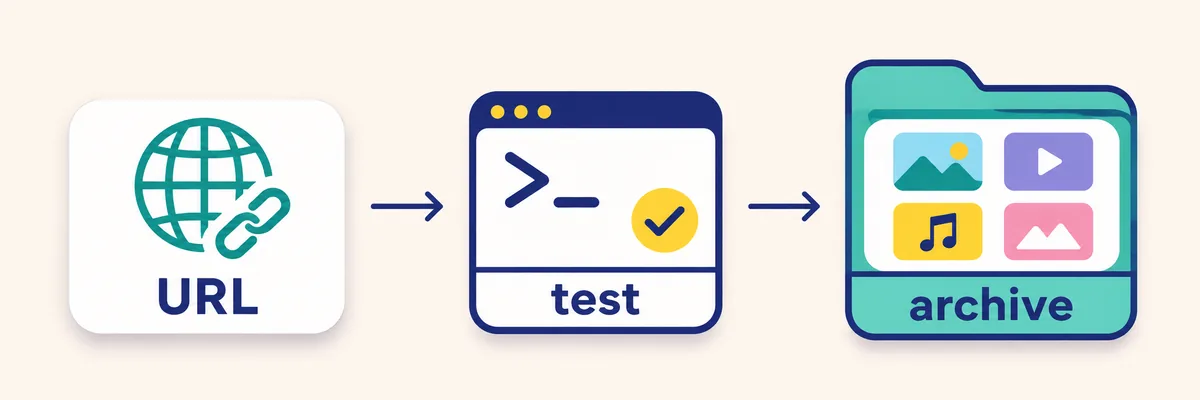
Extractor名、ブログまたは投稿ID、メディアURL、認証に関する警告を確認します。空の結果でもすぐにCookieを追加したり多くの設定を変えたりしません。URLが対応形式か、ブログが公開されているか、インストールしたバージョンが現在の応答を処理できるかを順番に確認します。
gallery-dl --simulate --verbose https://example.tumblr.com/gallery-dl -d ./tumblr-test https://example.tumblr.com/post/123456789gallery-dl --range 1-20 -d ./tumblr-sample https://www.tumblr.com/tagged/photographyブログ全体の保存はよくある用途ですが、すべての作業で最初に選ぶ必要はありません。一枚だけ必要なら投稿URLを使い、テーマを集めるならタグと小さい範囲を使います。未知の話題を探す場合は検索で候補を見つけ、後で投稿URLやブログURLの再現しやすい処理に変換します。
Extractorは写真だけを扱うとは限りません。動画や音声は別のメディア動作になり、テキスト、引用、回答の投稿はファイルを出さないことがあります。リブログのメタデータをファイル名に入れたくない場合もあります。フィルターを書く前に、シミュレーションで投稿タイプを確認してください。
大きなブログはチェックポイントに分けます。最初の範囲を実行し、フォルダーとアーカイブを確認してから広げます。ネットワークエラーで停止しても、安定した名前とアーカイブがあれば、過去の項目を新規として扱わずに再開できます。
まず投稿を検証し、次にブログやタグの範囲を検証し、その後Cookieが必要か判断します。最後に保存先とアーカイブを追加し、小さな結果が理解できてから繰り返します。この順番なら解析の問題とアクセスの問題を分けられます。
良い結果は説明できます。どのURLから出たか、ファイル数が妥当な理由、含めた投稿タイプ、保存先が分かります。大量に保存できても、再現や監査ができない処理は安全なワークフローとは言えません。
テストコマンドを理解したら、安定した選択をgallery-dlの設定へ移します。Tumblrのディレクトリ、ファイル名のフィールド、ダウンロードアーカイブ、控えめな待ち時間を一つのレビュー済み設定にまとめると、手動処理と定期処理の差が減ります。
Tumblrのファイル名は、どのブログか、どの投稿またはIDか、複数メディアの何番目かを示すと読みやすくなります。キーワードは推測せず、ファイル名ガイドで利用可能な項目を調べます。投稿タイプによって項目がない場合は、空の区切りに頼らず、読める代替を選びます。
アーカイブは処理済みIDの記録であり、メディアのバックアップではありません。設定のそばに置き、バックアップ計画に含め、URL情報を含む場合は公開しないでください。ディレクトリや名前を変えるとき、同じ論理項目を引き続き除外したい場合だけ同じアーカイブを使います。
{
  "extractor": {
    "tumblr": {
      "directory": ["tumblr", "{blog_name}"],
      "filename": "{id}_{num:>02}.{extension}",
      "archive": "./state/tumblr-{blog_name}.sqlite3"
    }
  }
}gallery-dl --list-keywords https://example.tumblr.com/フォルダー名を変えてもアーカイブの識別子は変わりません。ファイルを移動したり新しい保存先に分けたりする前に、同じ投稿を今後も除外するか決めてください。
Tumblrアーカイブは、何を求めているかをコマンドに表すと管理しやすくなります。最初は範囲を指定し、利用できるメタデータで日付や投稿を絞り、混在コンテンツが不要なら投稿タイプを条件にします。条件が何も一致しないとExtractorの故障に見えるため、必ずシミュレーションで確認します。
短い待ち時間、控えめな範囲、停止条件は、複数の全ブログ処理を並列で動かすより安全です。Tumblrがレート制限や一時エラーを返したら停止し、ログを残して、後で小さい範囲とゆっくりした速度で試します。アカウントを入れ替えてブロックを回避しないでください。
技術的に保存できることは、再公開の許可を意味しません。作者の条件、Tumblrのポリシー、メディアのライセンスや著作権を確認し、非公開または機微な内容を公開アーカイブへ入れないでください。
| 制御項目 | 効果 | 確認すること |
|---|---|---|
| 小さい範囲 | 最初の書き込みを制限 | 範囲と想定順序が一致 |
| 投稿タイプ | 不要な内容を除外 | シミュレーションで一致を確認 |
| 待ち時間 | 急なアクセスを減らす | 遅い実行でも現実的 |
| アーカイブ | 既知IDをスキップ | 安定したパスでバックアップ済み |
| 別の保存先 | 既存ファイルを守る | テストフォルダーを削除できる |
コマンドを変える前に失敗の種類を分けます。404や空の結果は、URLのコピー違い、ブログの移転、対応外のパスかもしれません。403やログイン表示はアクセス、同意、Cookie、サイトのポリシー応答を示します。タイムアウトや429は速度、ネットワーク、一時的な制限を示します。原因ごとに対処を変えてください。
URLの問題なら通常のブラウザーでページを開き、正規形に近いURLをコピーし、一件を`--simulate --verbose`で再試行します。アクセスの問題なら公開投稿と認証済みセッションを比較し、その結果が示す場合だけCookieヘルパーを使います。制限なら停止して待ち、範囲を小さくし、並列処理を避けます。ファイル数が想定外なら投稿タイプ、リブログ、テーマ素材、フィルターを調べてからアーカイブを消します。
助けを求めるときは元のエラー文を残します。gallery-dlのバージョン、OS、機密情報を除いたコマンド、プライベートトークンを外したURLの形、公開シミュレーションが動くかを伝えます。Cookieや非公開メディアは添付しません。
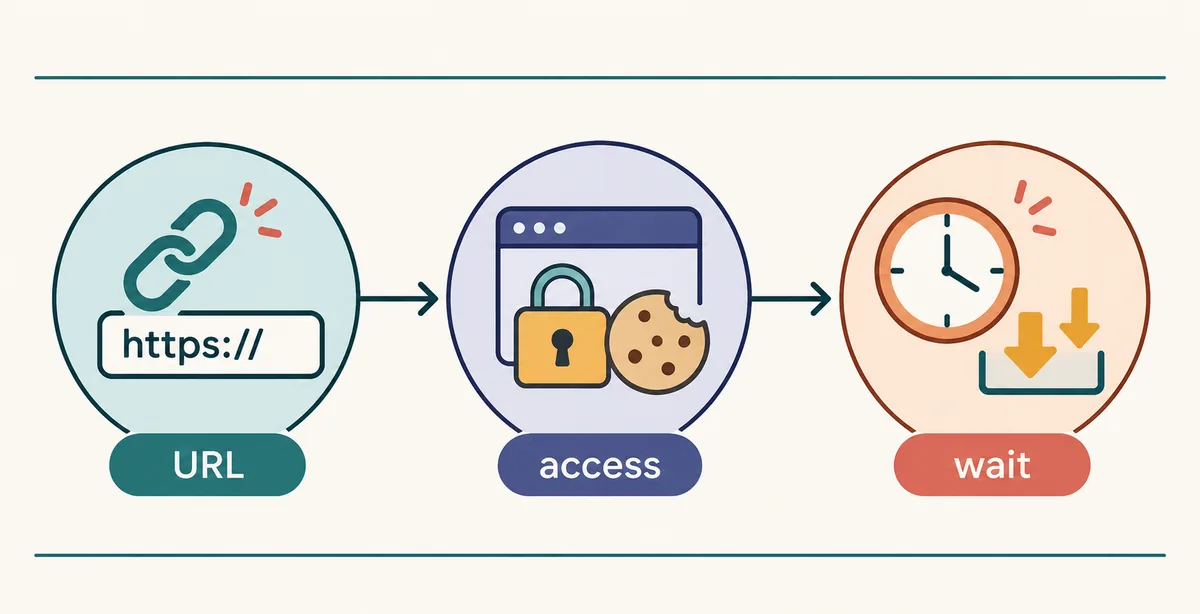
URLの形を確認し、一件をテストし、公開と認証済みのアクセスを比べ、その後でフィルターや保存先を変更します。この順序なら単純な形式ミスを複雑な設定実験にしません。
ここでは再現可能なTumblr処理に関わる質問へ答えます。インストール、設定、Cookie、一般的なトラブルは下の関連ページで詳しく確認できます。
対応する公開ブログURLを処理できますが、最初はシミュレーションと小さい範囲にします。投稿タイプや履歴が多い場合があるため、安定した保存先とアーカイブを用意してから広げます。
作者やコレクションならブログ、話題の小さなサンプルならタグ、一件の確認なら投稿を使います。検索URLは結果が変わるため発見用にします。
URLの形、公開状態、gallery-dlのバージョン、シミュレーション出力を確認します。誤ったパス、対応外の状態、空のフィルター、アクセス要求が原因になり得ます。
すべての公開ページに必要ではありません。公開比較とエラーがブラウザーセッションを示す場合だけ使い、Cookieファイルを非公開にします。Cookieは非公開内容の権限を与えません。
安定したアーカイブを設定し、処理と一緒に保管します。保存先や名前を変える場合は別のテストで、どのIDを抑制しているか確認します。
停止してログを残し、待ってから範囲を減らし、控えめな待ち時間で再試行します。並列リトライやアカウント切り替えで制限を回避しないでください。